
 纯合片段分析
 姓氏祖源
 祖源平均脸
 基因关系
 基因保险助手
 原始数据
 WeChat_AA7E44
综合讨论组
 精华
我做了一个古DNA祖源计算器,看看你的DNA来自哪里
如果把今天一个中国人的常染色体拆开,试着用几千年前那些已经被发掘、被测序的古代人群去解释它——能解释到什么程度?这是个老问题。古DNA领域用 qpAdm 这类方法处理它,但门槛高、要定制、跑一次要反复调模型。我们把它做成了一个所有人都能试的简化版本。
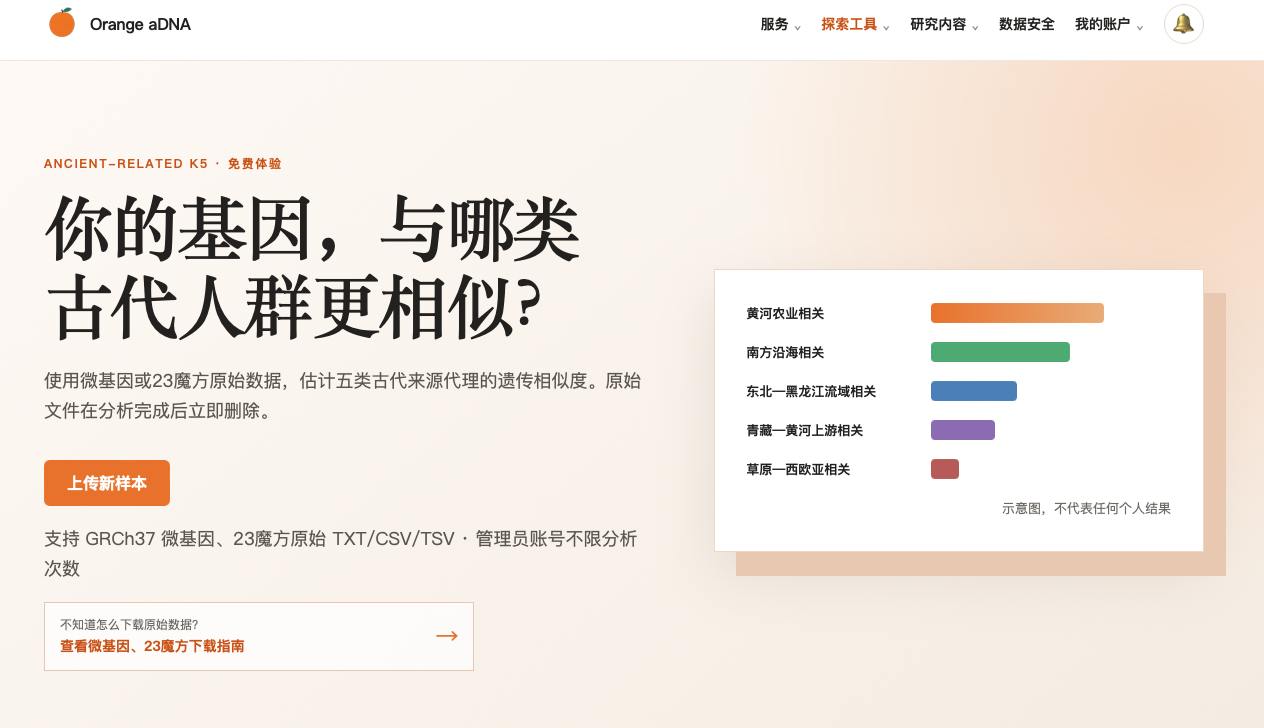
上传微基因原始数据或者直接通过微基因授权导入,得到你在五个固定古代来源方向上的拟合比例:
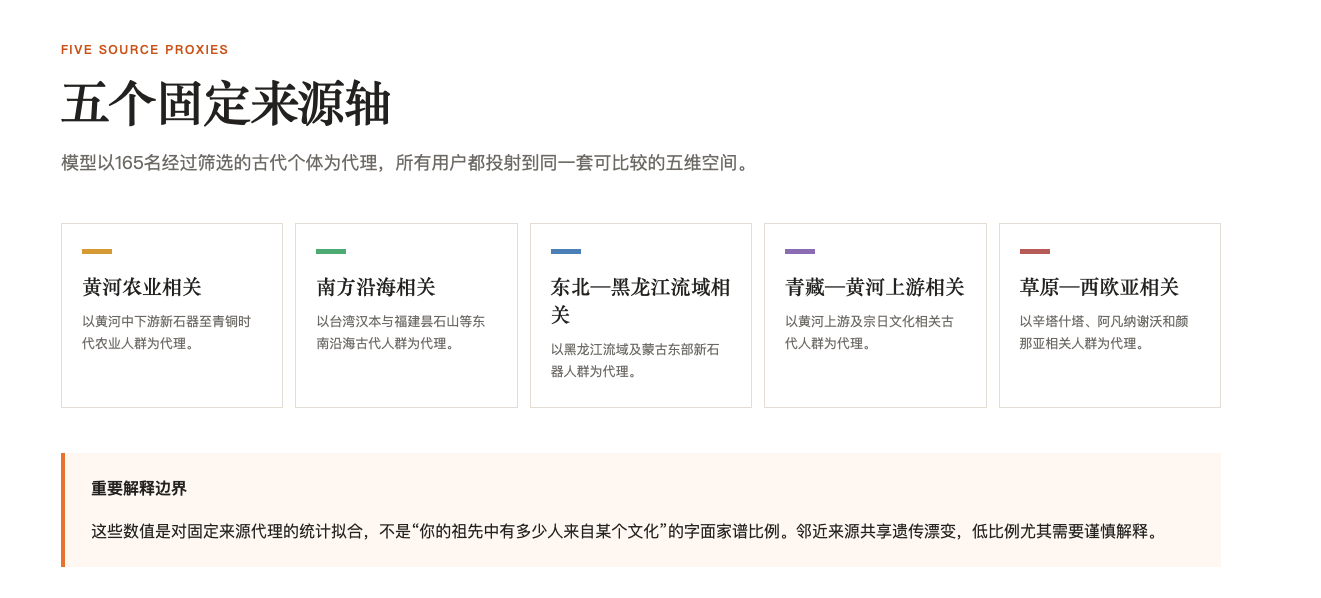
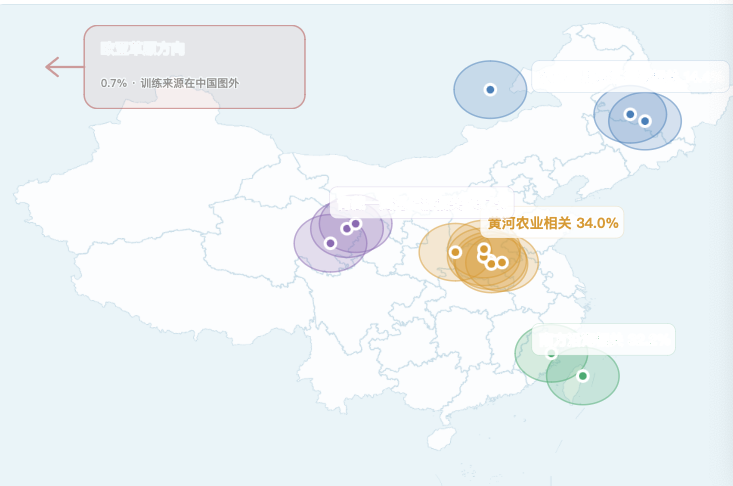
黄河农业相关|黄河中下游新石器至青铜时代农业人群
南方沿海相关|台湾汉本、福建昙石山等东南沿海古代人群
东北—黑龙江流域相关|黑龙江流域及蒙古东部新石器人群
青藏—黄河上游相关|黄河上游与宗日文化相关人群
草原—西欧亚相关|辛塔什塔、阿凡纳谢沃、颜那亚
注册后免费体验一次。
👉 orangeadna.com/ancient-components
先说清楚它不是什么这一段放在最前面,因为它比功能本身更重要。
它不是"你有多少祖先来自某个文化"。
30% 黄河农业相关,不等于你有三成祖先出生在黄河流域;10% 草原相关,也不等于你的家谱里有十分之一的人属于某个草原文化。
原因在于:这五个来源代理本身就不是五个纯净、互相独立的祖先群体。古代东亚人群之间长期存在交流和共享漂变,我们用五个固定方向去近似一个连续、复杂的遗传结构,是为了让结果可比较、可理解——代价就是它只能是一种统计拟合,不是家谱账本。
准确的读法是:在这个五来源模型里,你的常染色体有多少信息能被各个方向解释。
它用的是什么方法不是把你的数据加进参考集重跑 PCA,也不是找 PCA 上最近的人群;也不是直接调用 ADMIXTURE 生成一个无监督的 K=5。
实际做法是固定来源频率的有约束最大似然拟合:
先从古代参考数据估计五个来源在约 19.5 万个候选位点上的等位基因频率。对你的每一个有效位点,模型用五个比例加权这些频率,得到一个预测值,然后在"每项 ≥ 0、五项之和 = 100%"的约束下,寻找让你全部有效位点的二项似然最大的那组比例。
为了避免优化结果依赖初始值,每次分析从 6 组确定性起点分别拟合,再检查是否收敛一致。参考样本五个来源方向,取自 16 个精确的 AADR 群体标签,共 165 个唯一古代个体:
黄河农业相关
China_YR_MN(中国·黄河流域·新石器中期)
China_YR_LN(中国·黄河流域·新石器晚期)
China_YR_LBIA(中国·黄河流域·青铜时代晚期至铁器时代)
南方沿海相关
Taiwan_Hanben(台湾·汉本遗址)
Taiwan_Hanben_IA(台湾·汉本遗址·铁器时代)
Tanshishan(福建·昙石山遗址)
东北—黑龙江流域相关
China_AmurRiver_EarlyN(中国·黑龙江流域·新石器早期)
China_AmurRiver_N(中国·黑龙江流域·新石器时代)
Mongolia_East_N(蒙古国·东部·新石器时代)
青藏—黄河上游相关
China_Upper_YR_LN(中国·黄河上游·新石器晚期)
Zongri(青海·宗日遗址)
Zongri4.5k(青海·宗日遗址·距今约4500年组)
Zongri5.1k(青海·宗日遗址·距今约5100年组)
草原—西欧亚相关
Russia_MLBA_Sintashta(俄罗斯·青铜时代中晚期·辛塔什塔)
Russia_Afanasievo(俄罗斯·阿凡纳谢沃)
Russia_Samara_EBA_Yamnaya(俄罗斯·萨马拉·青铜时代早期·颜那亚)
括号内为标签的中文展开,仅说明缩写含义。这些是 AADR 用于数据整理的分析单元,不等同于考古学文化命名。
模型只匹配这些精确标签,不把 _lc 等近似标签的样本自动并入来源组。
需要说明的是,古代样本的可用量受制于全世界已发掘、已测序、且有可靠群体归属的基因组总数——这和消费级检测动辄几十万现代样本的数据库不是同一类东西。在古DNA研究中,一个 qpAdm 模型的单个来源群体常常只有几个到十几个个体,因此这里真正决定结果可靠性的不是总人数,而是每个方向的等位基因频率估计得是否稳定。
为此,模型要求每个入选位点在五个来源方向中各至少有 4 个非缺失个体,并剔除合并来源中 MAF 低于 1% 的位点。此外,v1 在 SNP 层面做了统一质控,但没有对这 165 个个体逐一做覆盖度、污染率、亲缘关系和离群值的独立复审——准确的表述是"从预定义的精确群体标签中选取唯一个体,在统一 SNP 质控标准下建模"。
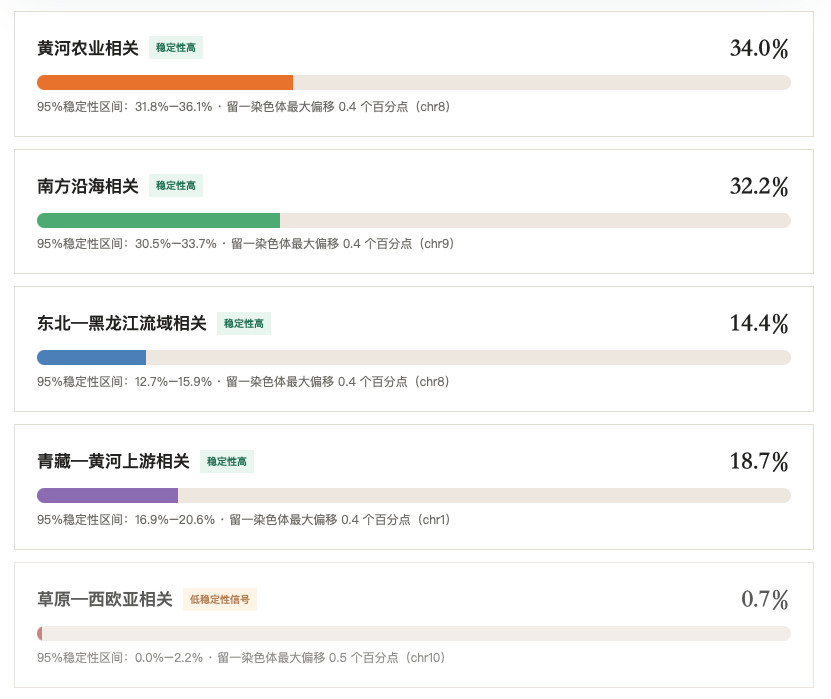
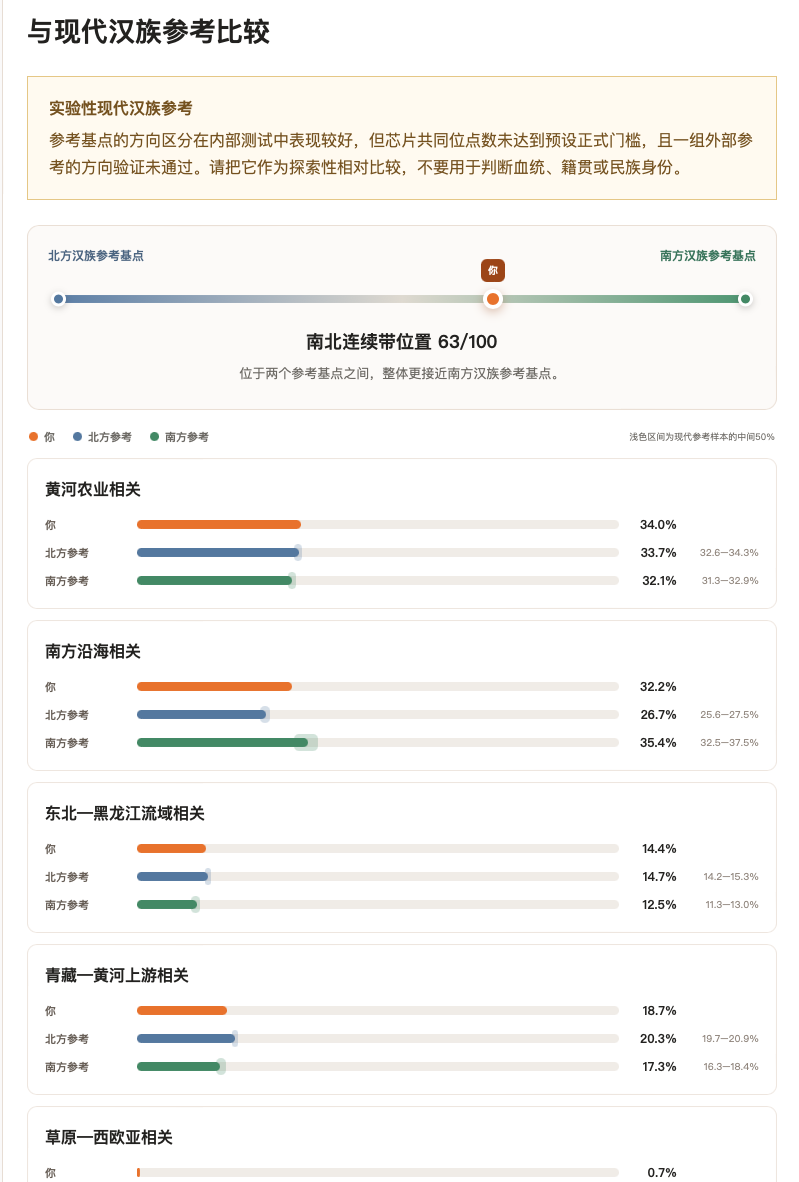
结果页会给你什么除了五项比例,还有一整套稳定性诊断:
每项成分的95% 稳定性区间与高/中/低稳定性等级
22 次留一染色体检查,以及影响最大的那条染色体和最大偏移
300 次染色体分块重复抽样
有效位点数与覆盖等级
一张匿名分享图
低于 2% 的成分会被明确标注为"低稳定性信号",不会把很小的数值包装成结论。
这里的"95% 区间"更应该理解为稳定性区间——它衡量的是结果对基因组区块变化有多敏感,不是某个历史祖源比例的置信区间。位点不够,我们宁可不出结果
有效 SNP
处理
≥ 80,000
标准覆盖(微基因实测约 92,000)
50,000–79,999
低覆盖,显示提示(23魔方实测约 59,000)
< 50,000
拒绝生成比例,且不消耗免费次数最后一条是刻意的。位点不足时强行算出一个"看起来很精确"的数字,是这类工具最常见的问题。
[图片]我们验证了什么,以及没验证什么内部验证包括留一个体、留一群体、已知比例的合成混合、两种芯片的位点遮罩测试、真实数据端到端测试等。
几个关键数字:
留一古代个体,来源 Top-1 命中96.36%
留一完整群体,来源 Top-1 命中62.50%
合成混合主要成分平均绝对误差0.37 个百分点
微基因/23魔方芯片遮罩误差0.30 / 0.39 个百分点
这些指标不能读成"对任意现代中国人的祖源判断准确率 96%"。它们检验的是模型能否恢复自己定义的五个轴,以及位点减少后是否稳定。
留一完整群体的 62.50% 明显低于留一个体的 96.36%——这说明模型对训练集之外的新来源泛化更困难。这也正是我们坚持把结果叫"古代相关成分"而不是"祖源比例"的原因。你的原始文件不会留下上传时边读取边加密,worker 直接从加密流解析,磁盘上不生成明文副本。任务完成、失败或超时后,原始文件立即删除。
数据库只保留五项比例、稳定性区间、有效位点数、覆盖等级、模型版本和必要的汇总诊断。不保存原始基因型、原始文件名或完整重抽样明细。什么时候该用更严格的方法K5 是体验版。如果你关心的是一个具体的历史问题——某个特定祖籍、某条候选迁徙路线、某两个来源哪个更说得通——那应该用针对性设计的 qpAdm 模型,选合适的外群和候选源,而不是把这五个固定方向当成最终答案。
这是第一版。随着参考样本、芯片验证和校准数据增加,五个轴和诊断方式都会继续更新。
支持微基因、23魔方原始 TXT / CSV / TSV(GRCh37)。注册用户在当前模型版本免费体验一次。
👉 orangeadna.com/ancient-components
上传微基因原始数据或者直接通过微基因授权导入,得到你在五个固定古代来源方向上的拟合比例:
黄河农业相关|黄河中下游新石器至青铜时代农业人群
南方沿海相关|台湾汉本、福建昙石山等东南沿海古代人群
东北—黑龙江流域相关|黑龙江流域及蒙古东部新石器人群
青藏—黄河上游相关|黄河上游与宗日文化相关人群
草原—西欧亚相关|辛塔什塔、阿凡纳谢沃、颜那亚
注册后免费体验一次。
👉 orangeadna.com/ancient-components
先说清楚它不是什么这一段放在最前面,因为它比功能本身更重要。
它不是"你有多少祖先来自某个文化"。
30% 黄河农业相关,不等于你有三成祖先出生在黄河流域;10% 草原相关,也不等于你的家谱里有十分之一的人属于某个草原文化。
原因在于:这五个来源代理本身就不是五个纯净、互相独立的祖先群体。古代东亚人群之间长期存在交流和共享漂变,我们用五个固定方向去近似一个连续、复杂的遗传结构,是为了让结果可比较、可理解——代价就是它只能是一种统计拟合,不是家谱账本。
准确的读法是:在这个五来源模型里,你的常染色体有多少信息能被各个方向解释。
它用的是什么方法不是把你的数据加进参考集重跑 PCA,也不是找 PCA 上最近的人群;也不是直接调用 ADMIXTURE 生成一个无监督的 K=5。
实际做法是固定来源频率的有约束最大似然拟合:
先从古代参考数据估计五个来源在约 19.5 万个候选位点上的等位基因频率。对你的每一个有效位点,模型用五个比例加权这些频率,得到一个预测值,然后在"每项 ≥ 0、五项之和 = 100%"的约束下,寻找让你全部有效位点的二项似然最大的那组比例。
为了避免优化结果依赖初始值,每次分析从 6 组确定性起点分别拟合,再检查是否收敛一致。参考样本五个来源方向,取自 16 个精确的 AADR 群体标签,共 165 个唯一古代个体:
黄河农业相关
China_YR_MN(中国·黄河流域·新石器中期)
China_YR_LN(中国·黄河流域·新石器晚期)
China_YR_LBIA(中国·黄河流域·青铜时代晚期至铁器时代)
南方沿海相关
Taiwan_Hanben(台湾·汉本遗址)
Taiwan_Hanben_IA(台湾·汉本遗址·铁器时代)
Tanshishan(福建·昙石山遗址)
东北—黑龙江流域相关
China_AmurRiver_EarlyN(中国·黑龙江流域·新石器早期)
China_AmurRiver_N(中国·黑龙江流域·新石器时代)
Mongolia_East_N(蒙古国·东部·新石器时代)
青藏—黄河上游相关
China_Upper_YR_LN(中国·黄河上游·新石器晚期)
Zongri(青海·宗日遗址)
Zongri4.5k(青海·宗日遗址·距今约4500年组)
Zongri5.1k(青海·宗日遗址·距今约5100年组)
草原—西欧亚相关
Russia_MLBA_Sintashta(俄罗斯·青铜时代中晚期·辛塔什塔)
Russia_Afanasievo(俄罗斯·阿凡纳谢沃)
Russia_Samara_EBA_Yamnaya(俄罗斯·萨马拉·青铜时代早期·颜那亚)
括号内为标签的中文展开,仅说明缩写含义。这些是 AADR 用于数据整理的分析单元,不等同于考古学文化命名。
模型只匹配这些精确标签,不把 _lc 等近似标签的样本自动并入来源组。
需要说明的是,古代样本的可用量受制于全世界已发掘、已测序、且有可靠群体归属的基因组总数——这和消费级检测动辄几十万现代样本的数据库不是同一类东西。在古DNA研究中,一个 qpAdm 模型的单个来源群体常常只有几个到十几个个体,因此这里真正决定结果可靠性的不是总人数,而是每个方向的等位基因频率估计得是否稳定。
为此,模型要求每个入选位点在五个来源方向中各至少有 4 个非缺失个体,并剔除合并来源中 MAF 低于 1% 的位点。此外,v1 在 SNP 层面做了统一质控,但没有对这 165 个个体逐一做覆盖度、污染率、亲缘关系和离群值的独立复审——准确的表述是"从预定义的精确群体标签中选取唯一个体,在统一 SNP 质控标准下建模"。
结果页会给你什么除了五项比例,还有一整套稳定性诊断:
每项成分的95% 稳定性区间与高/中/低稳定性等级
22 次留一染色体检查,以及影响最大的那条染色体和最大偏移
300 次染色体分块重复抽样
有效位点数与覆盖等级
一张匿名分享图
低于 2% 的成分会被明确标注为"低稳定性信号",不会把很小的数值包装成结论。
这里的"95% 区间"更应该理解为稳定性区间——它衡量的是结果对基因组区块变化有多敏感,不是某个历史祖源比例的置信区间。位点不够,我们宁可不出结果
有效 SNP
处理
≥ 80,000
标准覆盖(微基因实测约 92,000)
50,000–79,999
低覆盖,显示提示(23魔方实测约 59,000)
< 50,000
拒绝生成比例,且不消耗免费次数最后一条是刻意的。位点不足时强行算出一个"看起来很精确"的数字,是这类工具最常见的问题。
[图片]我们验证了什么,以及没验证什么内部验证包括留一个体、留一群体、已知比例的合成混合、两种芯片的位点遮罩测试、真实数据端到端测试等。
几个关键数字:
留一古代个体,来源 Top-1 命中96.36%
留一完整群体,来源 Top-1 命中62.50%
合成混合主要成分平均绝对误差0.37 个百分点
微基因/23魔方芯片遮罩误差0.30 / 0.39 个百分点
这些指标不能读成"对任意现代中国人的祖源判断准确率 96%"。它们检验的是模型能否恢复自己定义的五个轴,以及位点减少后是否稳定。
留一完整群体的 62.50% 明显低于留一个体的 96.36%——这说明模型对训练集之外的新来源泛化更困难。这也正是我们坚持把结果叫"古代相关成分"而不是"祖源比例"的原因。你的原始文件不会留下上传时边读取边加密,worker 直接从加密流解析,磁盘上不生成明文副本。任务完成、失败或超时后,原始文件立即删除。
数据库只保留五项比例、稳定性区间、有效位点数、覆盖等级、模型版本和必要的汇总诊断。不保存原始基因型、原始文件名或完整重抽样明细。什么时候该用更严格的方法K5 是体验版。如果你关心的是一个具体的历史问题——某个特定祖籍、某条候选迁徙路线、某两个来源哪个更说得通——那应该用针对性设计的 qpAdm 模型,选合适的外群和候选源,而不是把这五个固定方向当成最终答案。
这是第一版。随着参考样本、芯片验证和校准数据增加,五个轴和诊断方式都会继续更新。
支持微基因、23魔方原始 TXT / CSV / TSV(GRCh37)。注册用户在当前模型版本免费体验一次。
👉 orangeadna.com/ancient-components

 深圳市市场监督管理局企业主体身份公示
 中文
 English
7 个回复
赞同来自:
五类古代来源代理的遗传相似度
黄河农业相关
32.9%
南方沿海相关
37.9%
东北一黑龙江流域相关
14.3%
青藏﹣黄河上游相关
13.8%
草原﹣西欧亚相关
1.1%
全基因组稳定性:高.模型适配度:适配良好.适配等级:v1实验性诊断
微基因.91,992个有效 SNP .标准覆盖
提示:微基因 API 及全基因组档案目前属于试验支持。
赞同来自:
稳定性高
28.7%
南方沿海相关
稳定性高
21.5%
东北—黑龙江流域相关
稳定性高
22.0%
青藏—黄河上游相关
稳定性高
16.4%
草原—西欧亚相关
稳定性高
11.4%
赞同来自:
赞同来自:
赞同来自:
赞同来自:
赞同来自:
要回复问题请先登录或注册